
Résultats de tests NeoCloud
Les mêmes types de moteurs et de modèles que sur nos propres stations de travail, mesurés sur des GPU loués auprès de fournisseurs NeoCloud, à commencer par Google Colab. Chaque fournisseur NeoCloud aura sa propre section à mesure que nous le testons, et chaque notebook est publié sur GitHub.Moteurs et modèles mesurés sur des GPU NeoCloud, à commencer par Google Colab.
Google Colab
Nos notebooks ouverts exécutent des modèles de langage et d’images sur les environnements GPU de Google Colab Pro. Chacun installe un seul moteur, télécharge son modèle une fois dans Google Drive et le sert par une seule API authentifiée compatible avec OpenAI. Mesuré sur de vrais environnements Colab en novembre 2026, une requête à la fois.Nos notebooks ouverts sur les GPU de Google Colab Pro, mesurés en novembre 2026.
Le décodage est une réponse de 512 tokens à température 0. Le préremplissage et le délai avant le premier token utilisent une nouvelle requête d’environ 3 500 tokens sur un modèle déjà chargé (sans réutilisation du cache de préfixe) ; les notebooks pas encore relancés avec elle indiquent « prochain test ». Pour les images et les vidéos, la vitesse est mesurée par résultat après le premier.
L4 · 24 Go (classe RTX 4070 Ti)
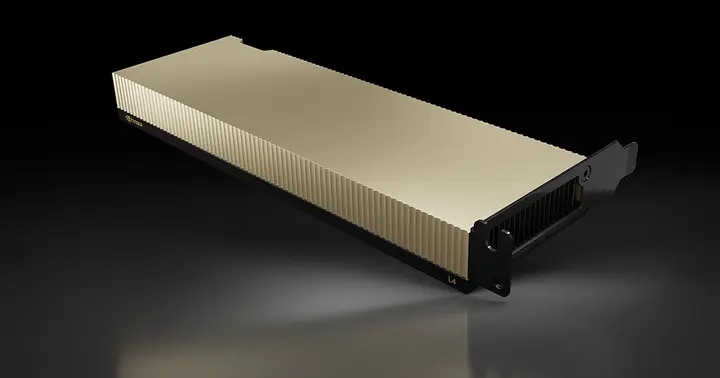
| Notebook du modèle | Moteur | Préremplissage t/s | Délai avant le premier token | Décodage t/s |
|---|---|---|---|---|
| nemotron-3.5-bolt-74b-iq2 | llama.cpp | —prochain test | —prochain test | 38 |
| qwen3.8-27b-w4a16-sglang | SGLang | —prochain test | —prochain test | 16 |
| flash-next-gyro-s | Strata | —prochain test | —prochain test | 68 |
| qwen3.8-27b-exl3-2bpw | TensorFold | —prochain test | —prochain test | 83 |
| Notebook du modèle | Moteur | Résultat | Temps par résultat |
|---|---|---|---|
| flux3-klein-comfy | ComfyUI | Image 1024×1024 | 8 s |
| minimax-h3-l4-comfy | ComfyUI | Clip vidéo de 5 s, 832×480 | 124 s |
| qwen-image-2.1-turbo-comfy | ComfyUI | Image 1024×1024 | 8 s |
| qwen-image-2.1-nf4 | Diffusers | Image | 37 s |
| sdxl-base | Diffusers | Image | 17 s |
| sdxl-turbo | Diffusers | Image | 3 s |
A100 · 80 Go (High-RAM)
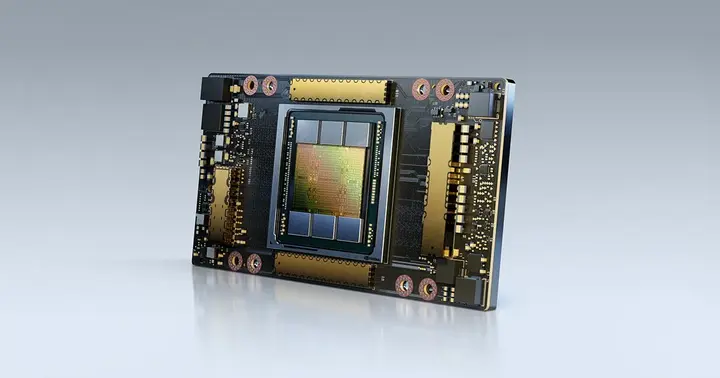
| Notebook du modèle | Moteur | Préremplissage t/s | Délai avant le premier token | Décodage t/s |
|---|---|---|---|---|
| nemotron-3.5-bolt-74b-iq2 | llama.cpp | —prochain test | —prochain test | 79 |
| sage-a1.5-q4 | llama.cpp | 3,558 | 1.00 s | 134 |
| qwen3.8-27b-w4a16-sglang | SGLang | 2,018 | 1.76 s | 74 |
| flash-next-strata-iq3-s | Strata | —prochain test | —prochain test | 167 |
| qwen3.8-27b-exl3-2bpw | TensorFold | —prochain test | —prochain test | 144 |
| Notebook du modèle | Moteur | Résultat | Temps par résultat |
|---|---|---|---|
| flux3-klein-comfy | ComfyUI | Image | 3 s |
| minimax-h3-comfy | ComfyUI | Clip vidéo de 5 s, 832×480 | 35 s |
| qwen-image-2.1-bf16-comfy | ComfyUI | Image 1024×1024 | 9 s |
| qwen-image-2.1-turbo-bf16-comfy | ComfyUI | Image 1024×1024 | 4 s |
| wan22-5b-comfy | ComfyUI | Clip vidéo de 5 s, 832×480 | 61 s |
G4 · RTX PRO 6000 Blackwell, 96 Go
| Notebook du modèle | Moteur | Préremplissage t/s | Délai avant le premier token | Décodage t/s |
|---|---|---|---|---|
| basalt-flash-next-nvfp4-dq6k | Basalt | —prochain test | —prochain test | 273 |
| hyperqwen-qwen3.8-27b-dflash2 | HyperQwen | —prochain test | —prochain test | ~315 |
| glm-maya-s | Maya | —prochain test | —prochain test | 77 |
| qwen3.8-27b-w4a16-sglang | SGLang | —prochain test | —prochain test | 77 |
Les autres notebooks A100 et G4 sont encore en cours de test.
Prêt à commencer ?
Parlez-nous de votre environnement, nous concevrons un déploiement qui garde vos données chez vous.