
Résultats des tests d’IA locale
Mesures de vitesse réelles sur nos deux stations de test : une configuration à deux Radeon RX 7900 XTX et une configuration RTX 3080 Ti + RTX 3080. Chaque modèle tourne sur notre propre matériel, et les lanceurs, réglages et résultats bruts sont publiés sur GitHub.Vitesses réelles mesurées sur nos stations de test AMD et NVIDIA.
Résultats de tests en conditions réelles : AMD Radeon
Résultats de la configuration actuelle de notre station AMD, selon ses essais les plus récents : de courts tests d’appel d’outil le 9 novembre 2026, dans la disposition finale des cartes, avec un préremplissage calculé à partir du délai avant le premier token. Les lanceurs et la configuration sont publiés sur GitHub.Un exemple concret de nos résultats de tests.
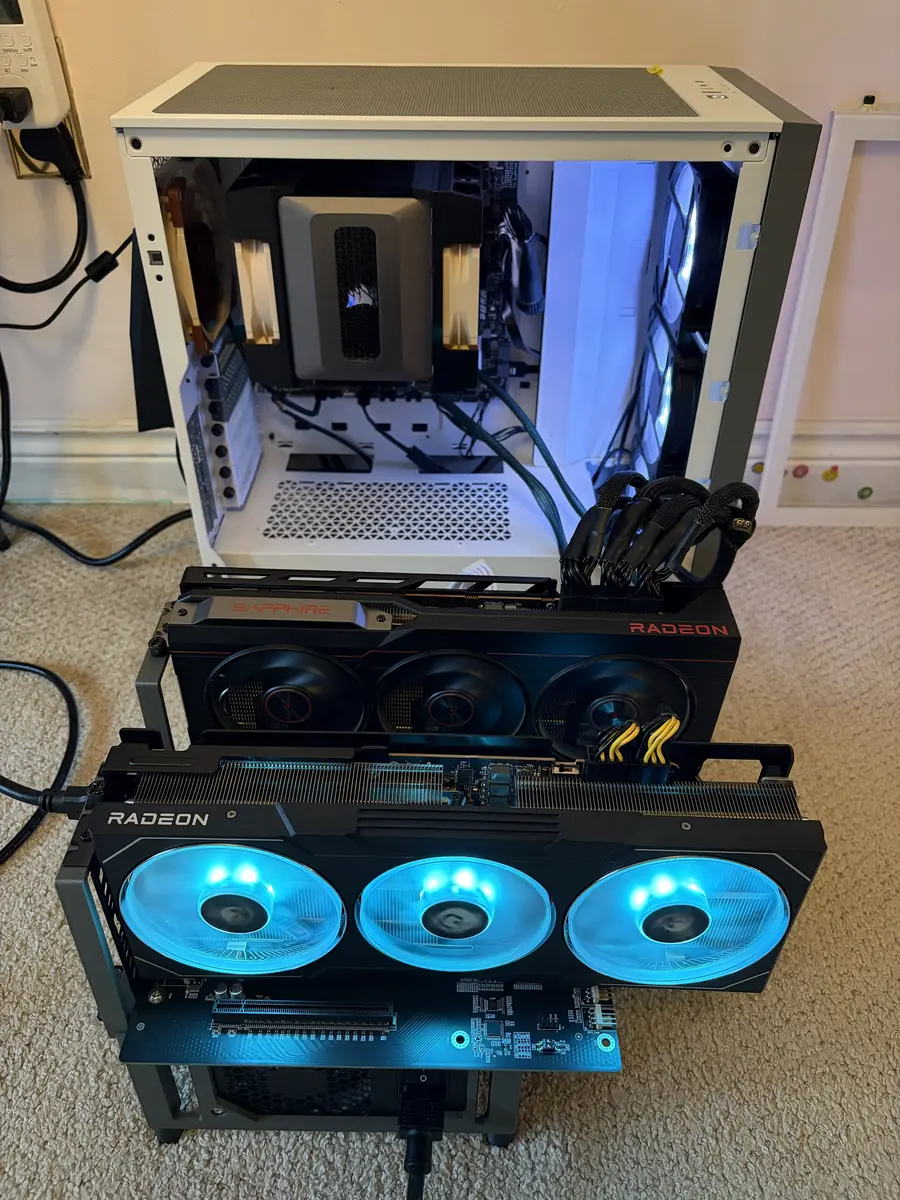
Deux GPU Radeon, 48 Go de VRAM
Un Intel Core i5-13600KF sur une carte mère ASUS B760M avec 64 Go de DDR5 et deux cartes AMD Radeon RX 7900 XTX, sous Ubuntu. Les deux cartes sont reliées par un commutateur PCIe Broadcom, en x8 chacune , et les transferts directs entre GPU par le commutateur sont activés (environ 13,8 Go/s dans chaque sens lors des tests). Chaque modèle est réparti sur les deux cartes.Core i5 avec deux Radeon RX 7900 XTX derrière un commutateur PCIe sous Ubuntu, chaque modèle réparti sur les deux.
Cinq moteurs, une seule API
SGLang et vLLM sur ROCm avec parallélisme tensoriel sur les deux cartes, llama.cpp sur HIP pour les modèles à mélange d’experts, et Strata et Maya sur HIP pour les modèles lus en continu depuis le SSD, chacun figé sur une version testée. Un seul moteur tourne à la fois derrière une passerelle authentifiée compatible OpenAI, qui démarre ou bascule vers le modèle demandé, de sorte que les mêmes outils de discussion et d’agent atteignent tous les modèles.SGLang, vLLM, llama.cpp, Strata et Maya sur les deux cartes, un à la fois derrière une seule API authentifiée qui charge le modèle demandé.
Empero à 173 tokens/s, 256K de contexte
Empero, un modèle à mélange d’experts gardé entièrement en mémoire GPU, tourne à 173 tokens par seconde sur la configuration actuelle avec un contexte de 256K. Neuf configurations de modèles sont validées sur cette machine : Qwen3.8-27B sur SGLang et vLLM, Nemotron Bolt et Ripple-65B en mémoire GPU, et Qwen3.8-Flash-Next, DeepSeek V4.1 Flash et GLM-5.3-Flash lus en continu depuis le SSD par Strata et Maya.Empero à 173 tokens par seconde avec 256K de contexte sur la configuration actuelle, et 9 configurations de modèles validées.
| Modèle / quantification | Moteur | Contexte | Préremplissage t/s | Délai avant le premier token | Décodage t/s |
|---|---|---|---|---|---|
| Modèles entièrement en VRAM | |||||
| Qwen3.8-27B | |||||
| INT4Appels d’outils | SGLang TP2 + DFlash2 | 160K | 1,736entrée ÷ délai avant le premier token | 3.86 s | 211.2 |
| INT4Appels d’outils | vLLM TP2 | 160K | 1,766entrée ÷ délai avant le premier token | 3.64 s | 155.1 |
| llama.cpp | |||||
| Empero Qwen3.8-35B-A3B IQ4_XSAppels d’outils | llama.cpp HIP + MTP3 | 256K | 2,893entrée ÷ délai avant le premier token | 2.22 s | 173.3 |
| vLLM | |||||
| Nemotron 3.5 Bolt 74B AutoRound W4A16Appels d’outils | vLLM TP2 + Triton int4 MoE | 256K | 1,963entrée ÷ délai avant le premier token | 3.55 s | 40.1 |
| Ripple-65B Preview GPTQ W4A16Appels d’outils | vLLM TP2 | 64K | 764entrée ÷ délai avant le premier token | 8.18 s | 28.0 |
| Modèles MoE lus en continu depuis le SSD | |||||
| Strata | |||||
| Qwen3.8-Flash-Next IQ3_XXSAppels d’outils | Strata HIP + MTP | 256K | 740entrée ÷ délai avant le premier token | 8.38 s | 86.3 |
| DeepSeek V4.1 Flash 1017 | |||||
| UD-IQ1_SAppels d’outils | Maya HIP | 32K | 35entrée ÷ délai avant le premier token | 182.22 s | 6.8 |
| UD-IQ1_SAppels d’outils | Strata HIP | 32K | 111entrée ÷ délai avant le premier token | 57.21 s | 5.6 |
| Maya | |||||
| GLM-5.3-Flash IQ2_XXSAppels d’outils | Maya HIP | 32K | 57entrée ÷ délai avant le premier token | 105.75 s | 5.2 |
Classement de qualité
| Modèle / quantification | Rang | Score (intervalle à 95 %) | Code (20) | Consignes (32) | Connaissances (60) | Maths (40) | Raisonnement (32) | Outils (32) |
|---|---|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next IQ3_XXSStrata (fork RDNA3) | 1 | 78.2%72.3–83.2% | 12 | 30 | 48 | 33 | 23 | 23 |
| DeepSeek V4.1 Flash 1017 UD-IQ1_SMaya | 2 | 77.8%71.8–82.8% | 12 | 28 | 51 | 29 | 22 | 26 |
| Qwen3.8-27B INT4SGLang | 3 | 75.5%69.3–80.7% | 8 | 31 | 47 | 32 | 18 | 27 |
| Empero Qwen3.8-35B-A3B IQ4_XSllama.cpp | 4 | 69.9%63.5–75.6% | 11 | 25 | 47 | 24 | 16 | 28 |
| Nemotron 3.5 Bolt 74B AutoRound W4A16vLLM | 5 | 66.2%59.7–72.2% | 7 | 23 | 46 | 30 | 15 | 22 |
| GLM-5.3-Flash IQ2_XXSMaya | 6 | 63.0%56.3–69.1% | 10 | 25 | 43 | 11 | 21 | 26 |
| Ripple-65B Preview GPTQ W4A16vLLM | 7 | 62.0%55.4–68.2% | 5 | 17 | 42 | 32 | 14 | 24 |
| Configuration de test | |
|---|---|
| Processeur | Intel Core i5-13600KF |
| Carte mère | ASUS TX GAMING B760M WIFI |
| Mémoire | 64 Go de DDR5 (61,6 Gio utilisables) |
| Cartes graphiques | 2× AMD Radeon RX 7900 XTX de 24 Go chacune (48 Go au total) |
| Liaisons GPU | Les deux cartes derrière un commutateur PCIe Broadcom PEX88096, en x8 chacune (liaison montante Gen4 x16) ; transferts directs entre GPU activés, environ 13,8 Go/s dans chaque sens lors des tests |
| Alimentation | Deux alimentations : l’une pour la carte de commutation PCIe et les deux cartes graphiques, l’autre pour le reste du système |
| Stockage des modèles | SSD NVMe et SATA |
| Système d’exploitation | Ubuntu, noyau Linux 7.0 |
| Logiciel GPU | ROCm 7.2.3 (HIP) |
| Résultats mesurés sur | Qwen3.8-Flash-Next : le 18 novembre 2026, sur le fork Strata RDNA3 sans budget fixe de RAM pour les experts. Toutes les autres lignes : configuration actuelle dans sa disposition des cartes du 7 novembre, le 9 novembre 2026, une courte requête d’appel d’outil chacune, transferts directs entre GPU activés (GLM-5.3-Flash avec un délai de surveillance plus long pendant son chargement) |
Notre méthode
- Un seul modèle est chargé à la fois, réparti sur les deux cartes. Le chargement du modèle et les essais de chauffe sont exclus de tous les chiffres.
- Chaque ligne reprend l’essai le plus récent sur la configuration actuelle. Lorsqu’une valeur n’a pas été mesurée lors de cet essai, la cellule reprend le résultat antérieur le plus récent sur la configuration actuelle, avec sa date.
- Préremplissage et délai avant le premier token (9 novembre) : une vraie requête d’appel d’outil d’environ 5 900 à 7 000 tokens en entrée, avec 25 définitions d’outils, par l’API normale. Le client ne mesure que le délai avant le premier token (de l’envoi de la requête au premier contenu, analyse de l’appel d’outil comprise) et la durée totale de la requête ; le préremplissage est donc calculé comme entrée ÷ délai avant le premier token.
- Décodage (9 novembre) : les tokens de la réponse d’appel d’outil divisés par le temps écoulé entre le premier token et la fin de la requête. La réponse est un appel d’outil d’environ 54 à 171 tokens : c’est une courte rafale, pas un débit soutenu.
- Le contexte est la fenêtre pour laquelle le profil installé est configuré.
- Vérifications réussies : Appels d’outils signifie que le modèle a réalisé un aller-retour avec un outil et une réponse de suivi par l’API normale.
- Depuis le 9 novembre 2026, les mises à jour des moteurs sont vérifiées chaque jour et installées à la main plutôt que par un outil nocturne : chaque nouvelle version est adoptée sauf si elle casse vraiment quelque chose (un test d’appel d’outil échoué, un plantage, moins de la moitié de la vitesse actuelle ou plus de trois fois le délai avant le premier token).
Matériel NVIDIA et résultats
Matériel actuel · Ubuntu : RTX 3080 Ti + RTX 3080 · 22 Go de VRAM
Notre station de test NVIDIA. Tous les résultats ci-dessous ont été mesurés les 5 et 6 novembre 2026, sur sa configuration actuelle avec 96 Go de mémoire.Notre station de test NVIDIA.
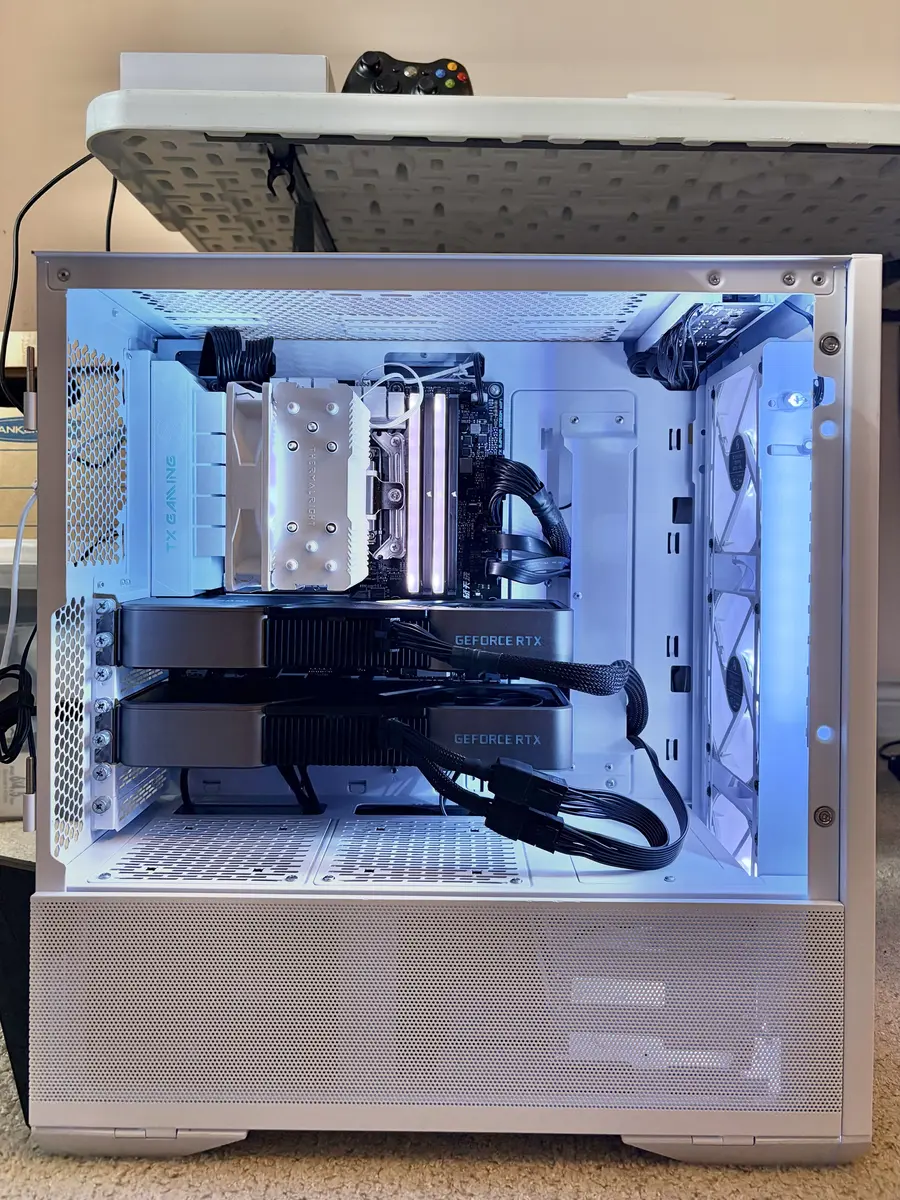
Deux cartes GeForce, 22 Go de VRAM
Un Intel Core i9-13900KS sur une carte mère MSI Z690 avec 96 Go de DDR5, sous Ubuntu 26.04 avec le pilote NVIDIA 615. La RTX 3080 Ti de 12 Go et la RTX 3080 de 10 Go ont chacune leur propre lien PCIe 4.0 x8 vers le processeur, sans liaison directe entre GPU, et la puce graphique intégrée du processeur gère l’affichage. La plupart des profils répartissent le modèle entre les deux cartes.Core i9, 96 Go de mémoire, une RTX 3080 Ti et une RTX 3080 sous Ubuntu.
Cinq moteurs, une seule API
HyperQwen sur vLLM et SGLang pour Qwen3.8-27B, gardé entièrement en mémoire GPU ; et llama.cpp, Strata et Maya pour les modèles à mélange d’experts, qui lisent leurs experts dans la mémoire système et sur le SSD. Un routeur de modèles derrière une API authentifiée compatible OpenAI charge un modèle à la fois.HyperQwen, SGLang, llama.cpp, Strata et Maya, un modèle à la fois derrière une seule API authentifiée.
Jusqu’à 84 tokens/s sur 22 Go
Strata lit en continu depuis le SSD la version IQ3_XXS de Qwen3.8-Flash-Next à 84 tokens par seconde avec un contexte de 128K. Nemotron Bolt, dans la version native 2 bits de NVIDIA en partie en mémoire vive, tourne à 68 tokens par seconde avec un contexte de 160K, et HyperQwen exécute la version 4 bits de Qwen3.8-27B entièrement en VRAM à 63 tokens par seconde avec un contexte de 84K.Jusqu’à 84 tokens par seconde en lecture depuis le SSD, 68 pour Bolt et 63 entièrement en VRAM.
| Modèle / quantification | Moteur | Contexte | Préremplissage t/s | Délai avant le premier token | Décodage t/s |
|---|---|---|---|---|---|
| Modèles entièrement en VRAM | |||||
| Qwen3.8-27B | |||||
| AutoRound INT4Appels d’outils | HyperQwen vLLM TP2 | 84K | 2,094.6 | 2.80 s | 62.7 |
| AutoRound INT4Appels d’outils | SGLang TP2 | 56K | 2,130.1 | 2.90 s | 60.12 |
| Modèles en partie en mémoire vive | |||||
| llama.cpp | |||||
| Nemotron 3.5 Bolt 74B native IQ2Appels d’outils | llama.cpp CUDA | 160K | 673.8 | 9.60 s | 67.8 |
| Modèles MoE lus en continu depuis le SSD | |||||
| Qwen3.8-Flash-Next | |||||
| IQ3_XXSAppels d’outils | Strata CUDA | 128K | 1,058.0 | 5.40 s | 83.7 |
| UD-IQ4_XS-v31Appels d’outils | Strata CUDA | 128K | 759.9 | 7.63 s | 43.7 |
| Maya | |||||
| GLM-5.3-Flash IQ2_XXSAppels d’outils | Maya CUDA | 64K | 550.9 | 10.06 s | 14.2 |
| DeepSeek V4.1 Flash 1017 | |||||
| UD-IQ1_SAppels d’outils | Strata CUDA | 32K | 87.1 | 65.59 s | 12.00 |
| UD-IQ1_SAppels d’outils | Maya CUDA | 32K | 209.4 | 28.84 s | 8.3 |
Classement de qualité
| Modèle / quantification | Rang | Score (intervalle à 95 %) | MMLU-Pro | AIME 2025 | LiveCodeBench | BFCL un tour | BFCL multitour |
|---|---|---|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 UD-IQ1_SStrata | 1 | 73.0%67.3–78.4% | 86.7% | 76.7% | 55.0% | 90.0% | 56.7% |
| Qwen3.8-27B AutoRound INT4SGLang | 2 | 68.1%62.3–73.9% | 85.7% | 66.7% | 50.0% | 91.7% | 46.7% |
| Qwen3.8-Flash-Next UD-IQ4_XS-v31Strata | 3 | 65.5%60.2–70.8% | 87.6% | 80.0% | 58.3% | 78.3% | 23.3% |
| Qwen3.8-Flash-Next IQ3_XXSStrata | 4 | 62.0%56.5–67.5% | 85.2% | 73.3% | 58.3% | 73.3% | 20.0% |
| GLM-5.3-Flash IQ2_XXSMaya | 5 | 57.2%52.1–62.3% | 86.2% | 6.7% | 55.0% | 91.7% | 46.7% |
| Nemotron 3.5 Bolt 74B native IQ2llama.cpp | 6 | 53.9%48.7–59.4% | 76.2% | 50.0% | 33.3% | 90.0% | 20.0% |
| Configuration de test | |
|---|---|
| Processeur | Intel Core i9-13900KS, puce graphique intégrée pour l’affichage |
| Carte mère | MSI MPG Z690 Carbon WiFi |
| Mémoire | 96 Go de DDR5 (environ 91.8 Gio utilisables) |
| Cartes graphiques | NVIDIA GeForce RTX 3080 Ti 12 Go + RTX 3080 10 Go (22 Go) |
| Liaisons GPU | Chaque carte sur son propre lien PCIe 4.0 x8 vers le processeur ; pas de liaison directe entre les GPU, les cartes échangent donc leurs données par la mémoire système |
| Stockage des modèles | Disque système NVMe pour les modèles lus en continu ; SSD SATA Samsung 870 QVO pour Qwen3.8-27B, Nemotron Bolt et une partie de DeepSeek |
| Système d’exploitation | Ubuntu 26.04, noyau Linux 7.0 |
| Logiciel GPU | Pilote NVIDIA 615.71.09, limites de puissance d’origine |
| Résultats mesurés sur | HyperQwen : 9 novembre 2026, après la mise à jour vers vLLM 0.33.0. Qwen3.8-Flash-Next : 16 novembre, après la mise à jour vers Strata 0.2.15. Qwen3.8-Flash-Next UD-IQ4_XS-v31 : 18 novembre, première requête après un chargement à froid, même moteur Strata. GLM et DeepSeek sur Maya : 18 novembre, après la mise à jour vers Maya 1.1.67. Nemotron Bolt : 13 novembre, après la mise à jour vers llama.cpp 1.0.0, avec son cache de requêtes en mémoire vive. SGLang et DeepSeek sur Strata : 5 novembre, lors d’une nouvelle série de mesures de tous les modèles. Le tout sur la configuration actuelle avec 96 Go de mémoire |
Notre méthode
- Un seul modèle est chargé à la fois, réparti sur les deux cartes. Le chargement du modèle est exclu, et le cache de fichiers du système n’est pas vidé.
- Chaque ligne correspond à une vraie requête d’appel d’outil d’environ 5 400 à 6 400 tokens en entrée et quelques dizaines en sortie par l’API normale, suivie d’une réponse de suivi exacte ; nous gardons la mesure réussie la plus rapide.
- Le préremplissage et le décodage viennent des compteurs propres au moteur ; le délai avant le premier token court de l’envoi de la requête au premier contenu, analyse de l’appel d’outil comprise.
- Le contexte est la fenêtre utilisée par le profil installé.
- Vérifications réussies : Appels d’outils signifie que le modèle a réalisé un aller-retour avec un outil et une réponse de suivi exacte par l’API normale.
- Depuis le 9 novembre 2026, les mises à jour des moteurs sont vérifiées chaque jour et installées à la main plutôt que par un outil nocturne : chaque nouvelle version est préparée à part, vérifiée avec le même court test d’appel d’outil avant et après le changement, et conservée sauf si elle casse vraiment quelque chose (une vérification échouée, moins de la moitié de la vitesse actuelle ou plus de trois fois le délai avant le premier token).
Génération d’images et de vidéos
Modèles de diffusion pour l’image et la vidéo mesurés dans ComfyUI sur nos stations AMD et NVIDIA : Qwen-Image, FLUX 3 Image Klein, MiniMax H3, Wan 2.2 et LTX 2.3.Modèles d’image et de vidéo mesurés dans ComfyUI.
Prêt à commencer ?
Parlez-nous de votre environnement, nous concevrons un déploiement qui garde vos données chez vous.